Text-to-Speech (Polly, Azure, ElevenLabs, Piper)
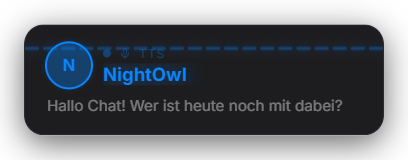
TTSModule liest Nachrichten per Sprachausgabe vor — ausgelöst per !tts, bei Spenden, im Meme-/OCR-/Zappi-Modul oder über das Quick-Control-Kontextmenü. Der Anbieter wird global gewählt (Sonstige Einstellungen › Integrationen › Text-to-Speech). Umschalten wirkt sofort, ohne Neustart. Piper braucht keinerlei Konto und läuft offline. Für die Karten-Ansicht (ohne Maskottchen) gibt es ein eigenes Aussehen-Panel mit Farb-Presets oder KI-Design. Neue Installationen nutzen seit 1.0.14 standardmäßig Piper; bestehende Installationen behalten ihren gewählten Anbieter. Lehnt ein Cloud-Anbieter die Zugangsdaten ab (ungültiger Key, falsche Region) oder sind gar keine hinterlegt, springt automatisch Piper ein, statt dass TTS, Spenden-Ansagen und Maskottchen stumm bleiben – das Log nennt die Ursache und wo sie zu beheben ist. Der „Startklar?“-Check auf der Zentrale hat dafür eine eigene Zeile „Sprachausgabe“. Neu in 1.0.15: „Maximale Länge“ (Standard 300 Zeichen) und „Wartezeit je Zuschauer“ (Standard aus) für !tts. Punkte werden erst nach dem Wortfilter abgezogen und erstattet, wenn die Sprachausgabe scheitert; ein Preis von 0 macht den Befehl kostenlos (ohne eigene Einstellung 30 Punkte). Während TTS spricht, wird die Musik leiser. Systemweite Hotkeys sind ab Werk nicht mehr belegt – bei bestehenden Installationen wurden die alten Vorbelegungen (Strg+P, Strg+T, Strg+Umschalt+C …) einmalig geleert, selbst gewählte bleiben. Neu in 1.0.17: Eigene Chat-Antwort bei zu langer TTS-Nachricht (Platzhalter {{name}}, {{length}}, {{max}}). Löscht ein Mod eine Nachricht oder bannt einen Zuschauer, werden dessen noch wartende TTS-Ansagen verworfen. Neu in 1.0.19: Karaoke: Die Vorlese-Karte markiert das gerade gesprochene Wort synchron zur Stimme (echte Wortzeiten bei Azure, ElevenLabs und Polly, bei Piper geschätzt). Die Karte ohne Maskottchen zeigt Profilbild mit Ring und eine audio-reaktive Anzeige (Equalizer, Pegel-Linie oder Ring, im Feintuning wählbar) sowie „+N wartend“. Die Karte erscheint erst, wenn die Stimme fertig erzeugt ist; die nächsten Ansagen werden vorab erzeugt. Alle sprechenden Module teilen sich einen Abspielweg, der TTS-Lautstärkeregler wirkt jetzt. Unter Sonstige Einstellungen → Sprachausgabe → „Qualität, Ausfallsicherheit & Cache“: Lautstärke-Angleichung, lokaler Sprach-Cache, automatischer Wechsel auf Piper bei Ausfall und ein Kosten-Limit für Cloud-Anbieter. Neuer TTS-Bereich im Quick Control (Überspringen, Pause, Test, Leeren, Lautstärke) und Tasten für Fernbedienung/Stream Deck. Premium: `!stimme` – Zuschauer wählen ihre Stimme aus einer freigegebenen Liste (`!stimme`, `!stimme <Name|Nr.>`, `!stimme reset`). Seit 1.0.24: Der Hotkey „Queue leeren“ entfernt nur noch TTS-Einträge aus der Warteschlange und erstattet deren Punkte zurück; der Sprach-Zwischenspeicher räumt im Hintergrund auf (weniger Hänger bei viel TTS). Neu in 1.0.28: Bei Abspielfehlern, „Queue leeren“, Einzel-Entfernen und Moderation werden die Punkte erstattet. `!TTS` funktioniert in jeder Schreibweise und erklärt sich bei falscher Eingabe, Ablehnungs-Antworten werden gedrosselt, der Vorspann-Sound lässt sich in der Länge begrenzen. Neue Automatisierungs-Auslöser „TTS vorgelesen“ und „TTS abgelehnt“.
Auslöser Chat-Befehl !tts <Text> (Standard: alle), Spenden-Vorlesung oder Quick-Control-Rechtsklick.
Voraussetzungen
- Piper (empfohlen zum Start): kein Konto, kein Key. Beim ersten Einsatz lädt die App die Piper-Binary (~20 MB) plus die deutsche Stimme de_DE-thorsten-medium (~60 MB) nach userData/piper-bin. Danach komplett offline.
- Amazon Polly: AWS-Konto + IAM-Benutzer mit polly:SynthesizeSpeech und polly:DescribeVoices, Access Key / Secret Key / Region.
- Azure Speech: Azure-Konto, „Speech"-Ressource, deren Schlüssel + Region (z.B. westeurope). 500.000 Zeichen/Monat sind gratis.
- ElevenLabs: Konto auf elevenlabs.io, API-Key aus dem Profil. Gratis-Kontingent ist klein (~10.000 Zeichen/Monat).
Schritt für Schritt
- Sonstige Einstellungen › Integrationen › „Text-to-Speech (Anbieter)" öffnen und unter „Anbieter" den gewünschten Dienst wählen.
- Piper: „Binary + deutsche Stimme automatisch nachladen" aktiviert lassen. Beim ersten !tts lädt alles nötige einmalig — währenddessen kurz warten. Eigene Piper-Installation? Pfad zu piper.exe und Stimmen-Ordner (.onnx / .onnx.json) in denselben Feldern eintragen.
- Amazon Polly: IAM-Benutzer anlegen, Policy „AmazonPollyReadOnlyAccess" zuweisen, dann Access Key ID / Secret Access Key / Region unter „Text-to-Speech (Zugangsdaten)" › Amazon Polly eintragen. (Alte config/aws-credentials.json wird beim ersten Start automatisch übernommen.)
- Azure Speech: Im Azure-Portal eine „Speech"-Ressource anlegen, unter „Schlüssel und Endpunkt" Key + Region kopieren und unter „Text-to-Speech (Zugangsdaten)" › Azure Speech eintragen.
- ElevenLabs: API-Key unter elevenlabs.io › Profil › API Keys erzeugen und unter „Text-to-Speech (Zugangsdaten)" › ElevenLabs eintragen. Optional eine eigene Voice-ID als Standard-Stimme setzen.
- Standard-Stimme wählen: Im selben Bereich unter „Standard-Stimmen je Anbieter" — das Auswahlfeld schlägt die verfügbaren Stimmen des jeweiligen Anbieters vor (Freitext bleibt möglich).
- Pro Modul feinjustieren: TTS-, Meme- und OCR-Tab haben eine eigene Stimmen-Liste (zufällige Auswahl); im Spenden-Tab lassen sich Ansager- und Spender-Stimme getrennt setzen.
- Rechte & Filter: Im Befehle-Tab festlegen, wer !tts nutzen darf; im TTS-Tab BadWordFilter und URL-Filter aktivieren.
Wenn's nicht klappt
- Kein Ton nach Anbieter-Wechsel: Prüfen, ob unter „Text-to-Speech (Zugangsdaten)" für den gewählten Anbieter ein gültiger Key/Region bzw. bei Polly Access Key hinterlegt ist. Die Zeile „Sonstige Einstellungen“ zeigt sonst keinen Fehler — der Fehler steht im Home-Log-Fenster.
- Piper: erster !tts dauert lange / kein Ton — der einmalige Download (~80 MB) läuft noch. Bei Firewall/Antivirus: piper.exe in userData/piper-bin freigeben. Ohne Internet vorab: Binary + Stimme manuell dorthin legen und die Pfade im Tab setzen.
- Azure: HTTP 401/403 — Key oder Region falsch (Region ist der Kurzname wie „westeurope“, nicht „West Europe“).
- ElevenLabs: HTTP 401 — Key ungültig; HTTP 429 — Monatskontingent aufgebraucht.
- Polly „AccessDenied“ / „not authorized to perform polly:SynthesizeSpeech“: IAM-Policy fehlt oder ist zu eng.
- Eine bestimmte Stimme wird ignoriert: Stimmnamen sind anbieterspezifisch (Polly „Vicki“, Azure „de-DE-KatjaNeural“, ElevenLabs eine ID, Piper „de_DE-thorsten-medium“). Bei unbekanntem Namen nutzt die App die Standard-Stimme des Anbieters.
- Zugangsdaten niemals ins Git committen — config/tts-credentials.json liegt verschlüsselt und ist per .gitignore ausgeschlossen.
- Nach einem Anbieterwechsel klingt die Stimme anders als eingestellt: Stimmen des alten Anbieters (z. B. „Vicki“ von Polly bei aktivem Azure) gibt es beim neuen nicht. Zappify nimmt dann sofort die Standard-Stimme des aktiven Anbieters und schreibt einmalig einen Hinweis ins Log – die Stimmen-Listen in den Modul-Tabs bei Gelegenheit anpassen.
Zuletzt aktualisiert: 15. November 2026